Statistik 2: Demo

Demoscript herunterladen (.R)

Demoscript herunterladen (.qmd)

ANOVA

t-test als ANOVA

# Dieselben Daten wie für die t-Tests in Statistik 1
Messwerte_a <- c(20, 19, 25, 10, 8, 15, 13, 18, 11, 14) 
Messwerte_b <- c(12, 15, 16, 7, 8, 10, 12, 11, 13, 10) 
cultivar <- factor(rep( c("Andro", "Bulli"), each = 10))
blume <- data.frame("cultivar" = cultivar, "size" = c(Messwerte_a, Messwerte_b) ) 

# Daten anschauen
library(ggplot2)

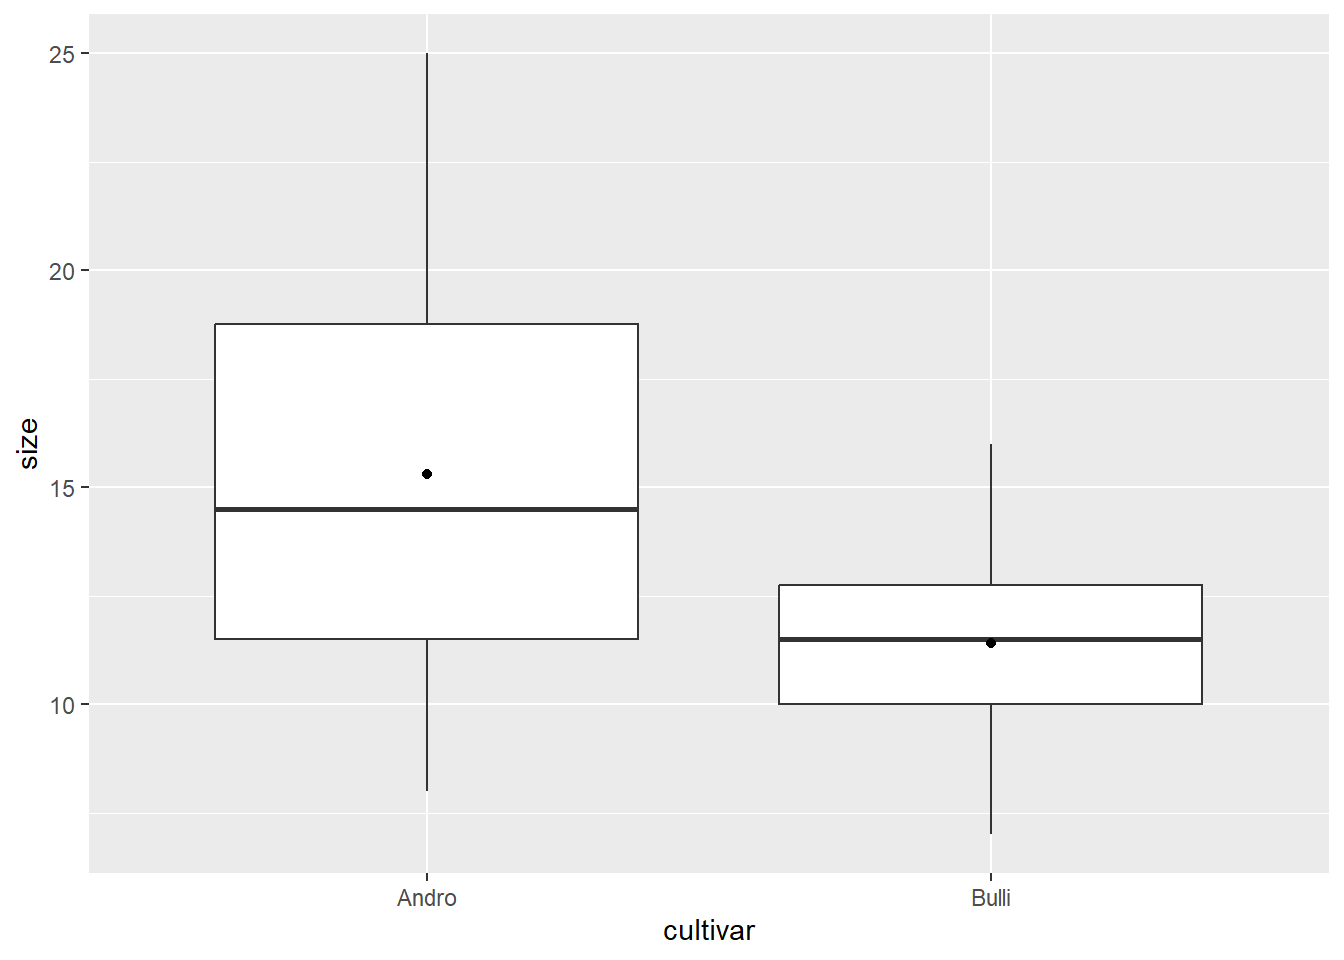
ggplot(blume, aes(cultivar, size)) +
  geom_boxplot() +
  stat_summary(fun = mean, geom = "point")

# Klassischer t-Test ausführen
t.test(size ~ cultivar, var.equal = TRUE, data = blume)

    Two Sample t-test

data:  size by cultivar
t = 2.0797, df = 18, p-value = 0.05212
alternative hypothesis: true difference in means between group Andro and group Bulli is not equal to 0
95 percent confidence interval:
 -0.03981237  7.83981237
sample estimates:
mean in group Andro mean in group Bulli 
               15.3                11.4 
# ANOVA ausführen
aov_1 <- aov(size ~ cultivar, data = blume)
aov_1
Call:
   aov(formula = size ~ cultivar, data = blume)

Terms:
                cultivar Residuals
Sum of Squares     76.05    316.50
Deg. of Freedom        1        18

Residual standard error: 4.193249
Estimated effects may be unbalanced
summary(aov_1)
            Df Sum Sq Mean Sq F value Pr(>F)  
cultivar     1   76.0   76.05   4.325 0.0521 .
Residuals   18  316.5   17.58                 
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
summary.lm(aov_1)

Call:
aov(formula = size ~ cultivar, data = blume)

Residuals:
   Min     1Q Median     3Q    Max 
-7.300 -2.575 -0.350  2.925  9.700 

Coefficients:
              Estimate Std. Error t value Pr(>|t|)    
(Intercept)     15.300      1.326   11.54 9.47e-10 ***
cultivarBulli   -3.900      1.875   -2.08   0.0521 .  
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 4.193 on 18 degrees of freedom
Multiple R-squared:  0.1937,    Adjusted R-squared:  0.1489 
F-statistic: 4.325 on 1 and 18 DF,  p-value: 0.05212

Echte ANOVA

# Eine weitere Sorte hinzufügen
Messwerte_c <- c(30, 19, 31, 23, 18, 25, 26, 24, 17, 20)
cultivar <- factor( rep( c("Andro", "Bulli", "Chroma"), each = 10))
blume2 <- data.frame("cultivar" = cultivar, 
                      "size" = c(Messwerte_a, Messwerte_b, Messwerte_c)) 


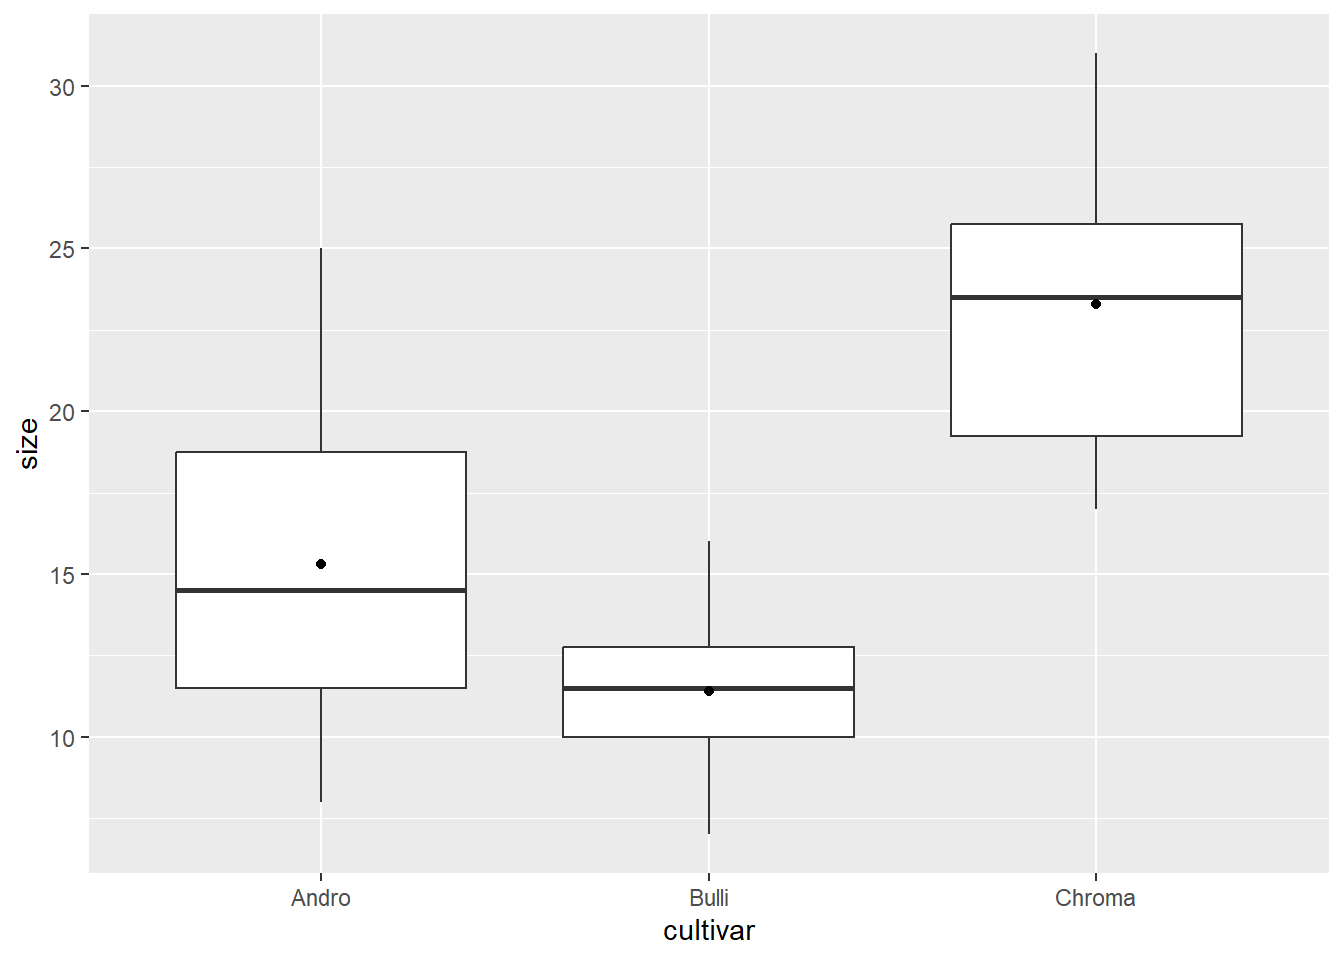
# Daten als Boxplots anschauen
ggplot(blume2, aes(cultivar, size)) +
  geom_boxplot() +
  stat_summary(fun = mean, geom = "point") 

Kennzahlen der Daten anschauen

library("dplyr")
blume2 |> 
  group_by(cultivar) |>
  summarise(
    Mean = mean(size), 
    SD = sd(size),
    Min = min(size),
    Max = max(size)
  )
# A tibble: 3 × 5
  cultivar  Mean    SD   Min   Max
  <fct>    <dbl> <dbl> <dbl> <dbl>
1 Andro     15.3  5.21     8    25
2 Bulli     11.4  2.84     7    16
3 Chroma    23.3  4.85    17    31
# ANOVA durchführen
aov_2 <- aov(size ~ cultivar, data = blume2)

summary(aov_2)
            Df Sum Sq Mean Sq F value   Pr(>F)    
cultivar     2  736.1   368.0    18.8 7.68e-06 ***
Residuals   27  528.6    19.6                     
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
summary.lm(aov_2)

Call:
aov(formula = size ~ cultivar, data = blume2)

Residuals:
   Min     1Q Median     3Q    Max 
-7.300 -3.375 -0.300  2.700  9.700 

Coefficients:
               Estimate Std. Error t value Pr(>|t|)    
(Intercept)      15.300      1.399  10.935 2.02e-11 ***
cultivarBulli    -3.900      1.979  -1.971 0.059065 .  
cultivarChroma    8.000      1.979   4.043 0.000395 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 4.425 on 27 degrees of freedom
Multiple R-squared:  0.582, Adjusted R-squared:  0.5511 
F-statistic:  18.8 on 2 and 27 DF,  p-value: 7.683e-06
# Direkt als lineares Modell
lm_1 <- lm(size ~ cultivar, data = blume2)
summary(lm_1)

Call:
lm(formula = size ~ cultivar, data = blume2)

Residuals:
   Min     1Q Median     3Q    Max 
-7.300 -3.375 -0.300  2.700  9.700 

Coefficients:
               Estimate Std. Error t value Pr(>|t|)    
(Intercept)      15.300      1.399  10.935 2.02e-11 ***
cultivarBulli    -3.900      1.979  -1.971 0.059065 .  
cultivarChroma    8.000      1.979   4.043 0.000395 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 4.425 on 27 degrees of freedom
Multiple R-squared:  0.582, Adjusted R-squared:  0.5511 
F-statistic:  18.8 on 2 and 27 DF,  p-value: 7.683e-06

Tukeys Posthoc-Test

# ANOVA und Posthoc-Test durchführen
library(multcomp)

aov_2 <- aov(size ~ cultivar, data = blume2)
posthoc <- glht(aov_2, linfct = mcp(cultivar = "Tukey"))
summary(posthoc)

     Simultaneous Tests for General Linear Hypotheses

Multiple Comparisons of Means: Tukey Contrasts


Fit: aov(formula = size ~ cultivar, data = blume2)

Linear Hypotheses:
                    Estimate Std. Error t value Pr(>|t|)    
Bulli - Andro == 0    -3.900      1.979  -1.971  0.13883    
Chroma - Andro == 0    8.000      1.979   4.043  0.00107 ** 
Chroma - Bulli == 0   11.900      1.979   6.014  < 1e-04 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
(Adjusted p values reported -- single-step method)
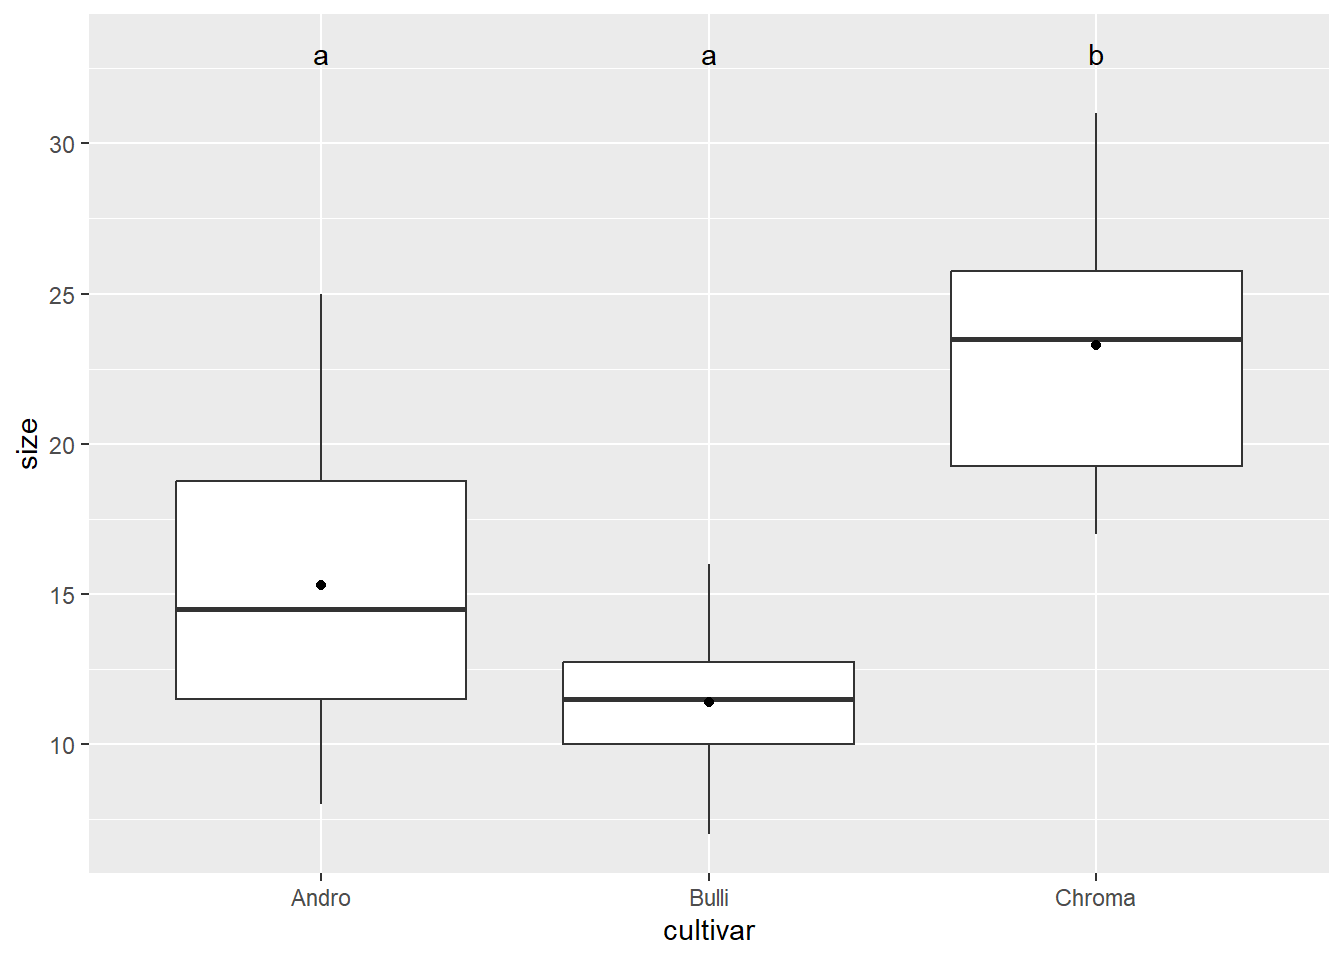
cld(posthoc)
 Andro  Bulli Chroma 
   "a"    "a"    "b" 
# Darstellung der Ergebnisse mit Post-Hoc-Labels über Boxplots

# Labels des Posthoc-Tests extrahieren
letters <- cld(posthoc)

labels <- data.frame(
  cultivar = names( letters$mcletters$Letters), 
  letters = letters$mcletters$Letters)

# In Plot darstellen
ggplot(blume2, aes(cultivar, size)) +
  geom_boxplot() +
  geom_text(data = labels, aes(x = cultivar, y = 33, label = letters)) +
  stat_summary(fun = mean, geom = "point")

2-faktorielle ANOVA

# Daten generieren
Messwerte_d <- c(10, 12, 11, 13, 10, 25, 12, 30, 26, 13)
Messwerte_e <- c(15, 13, 18, 11, 14, 25, 39, 38, 28, 24)
Messwerte_f <- c(10, 12, 11, 13, 10, 9, 2, 4, 7, 13)

blume3 <- data.frame(
    cultivar = c( rep("Andro", 20), rep("Bulli", 20), rep("Chroma", 20)),
    house = factor( c(rep(c(rep("yes", 10), rep("no", 10)), 3))),
    size = c(Messwerte_a, Messwerte_b, Messwerte_c, Messwerte_d, Messwerte_e, Messwerte_f)
)

table(blume3$cultivar, blume3$house)
        
         no yes
  Andro  10  10
  Bulli  10  10
  Chroma 10  10
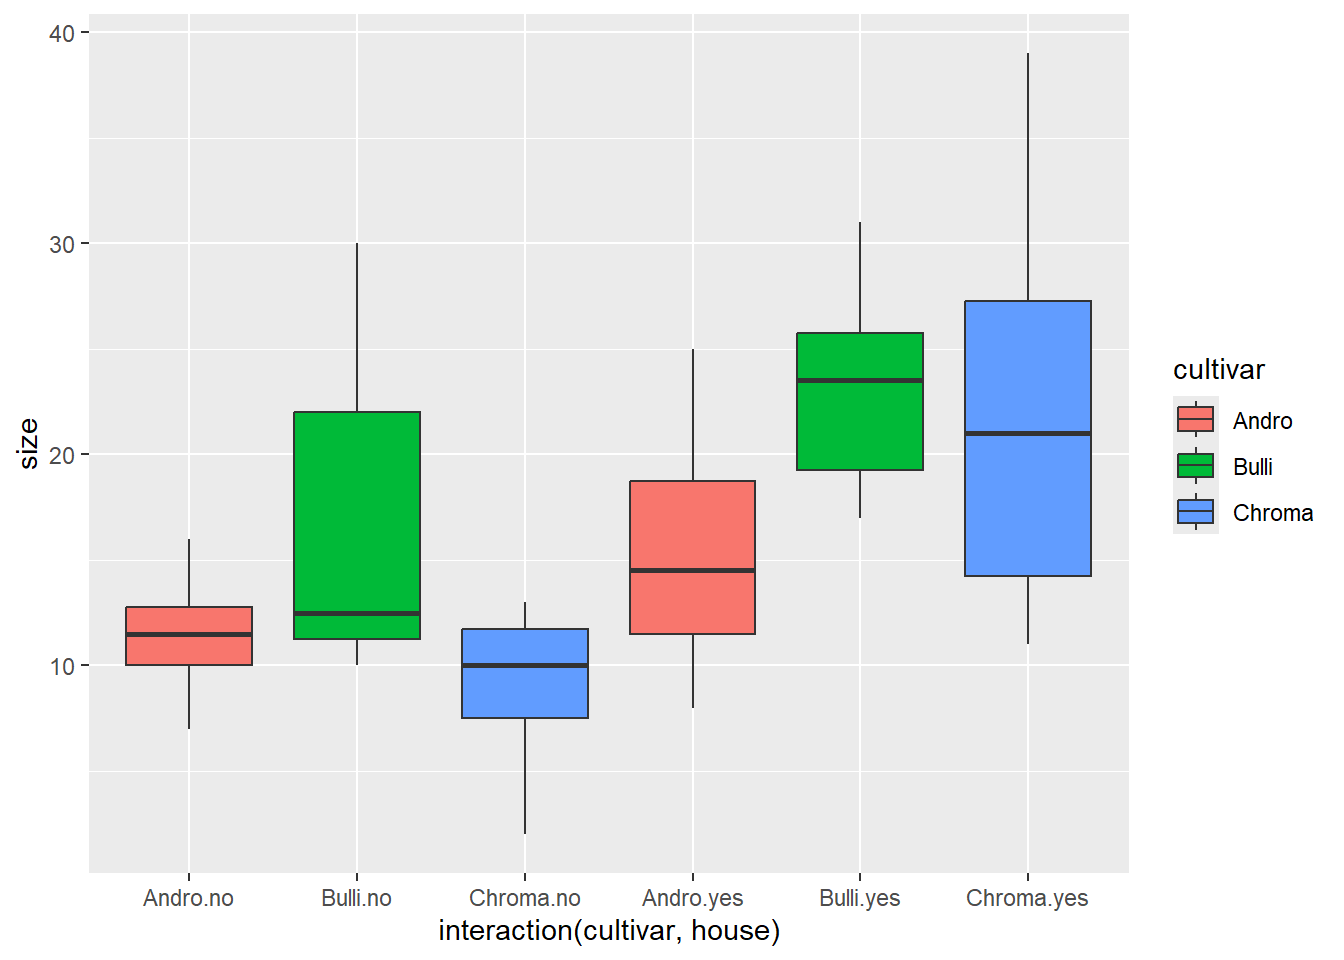
# Daten mit Boxplots anschauen
ggplot(blume3, aes(x = interaction(cultivar, house), y = size, fill = cultivar)) +
  geom_boxplot() 

aov_3 <- aov(size ~ cultivar + house, data = blume3)
summary(aov_3)
            Df Sum Sq Mean Sq F value   Pr(>F)    
cultivar     2  417.1   208.5   5.005     0.01 *  
house        1  992.3   992.3  23.815 9.19e-06 ***
Residuals   56 2333.2    41.7                     
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
aov_4a <- aov(size ~ cultivar + house + cultivar:house, data = blume3)
summary(aov_4a)
               Df Sum Sq Mean Sq F value   Pr(>F)    
cultivar        2  417.1   208.5   5.364   0.0075 ** 
house           1  992.3   992.3  25.520 5.33e-06 ***
cultivar:house  2  233.6   116.8   3.004   0.0579 .  
Residuals      54 2099.6    38.9                     
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
# Kurzschreibweise: "*" bedeutet, dass Interaktion zwischen cultivar und house 
# eingeschlossen wird
aov_4b <- aov(size ~ cultivar * house, data = blume3)
summary(aov_4b)
               Df Sum Sq Mean Sq F value   Pr(>F)    
cultivar        2  417.1   208.5   5.364   0.0075 ** 
house           1  992.3   992.3  25.520 5.33e-06 ***
cultivar:house  2  233.6   116.8   3.004   0.0579 .  
Residuals      54 2099.6    38.9                     
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
summary.lm(aov_4b)

Call:
aov(formula = size ~ cultivar * house, data = blume3)

Residuals:
    Min      1Q  Median      3Q     Max 
-11.500  -4.325  -0.300   3.075  16.500 

Coefficients:
                        Estimate Std. Error t value Pr(>|t|)    
(Intercept)               11.400      1.972   5.781 3.81e-07 ***
cultivarBulli              4.800      2.789   1.721   0.0909 .  
cultivarChroma            -2.300      2.789  -0.825   0.4131    
houseyes                   3.900      2.789   1.399   0.1677    
cultivarBulli:houseyes     3.200      3.944   0.811   0.4207    
cultivarChroma:houseyes    9.500      3.944   2.409   0.0194 *  
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 6.236 on 54 degrees of freedom
Multiple R-squared:  0.439, Adjusted R-squared:  0.3871 
F-statistic: 8.451 on 5 and 54 DF,  p-value: 5.86e-06
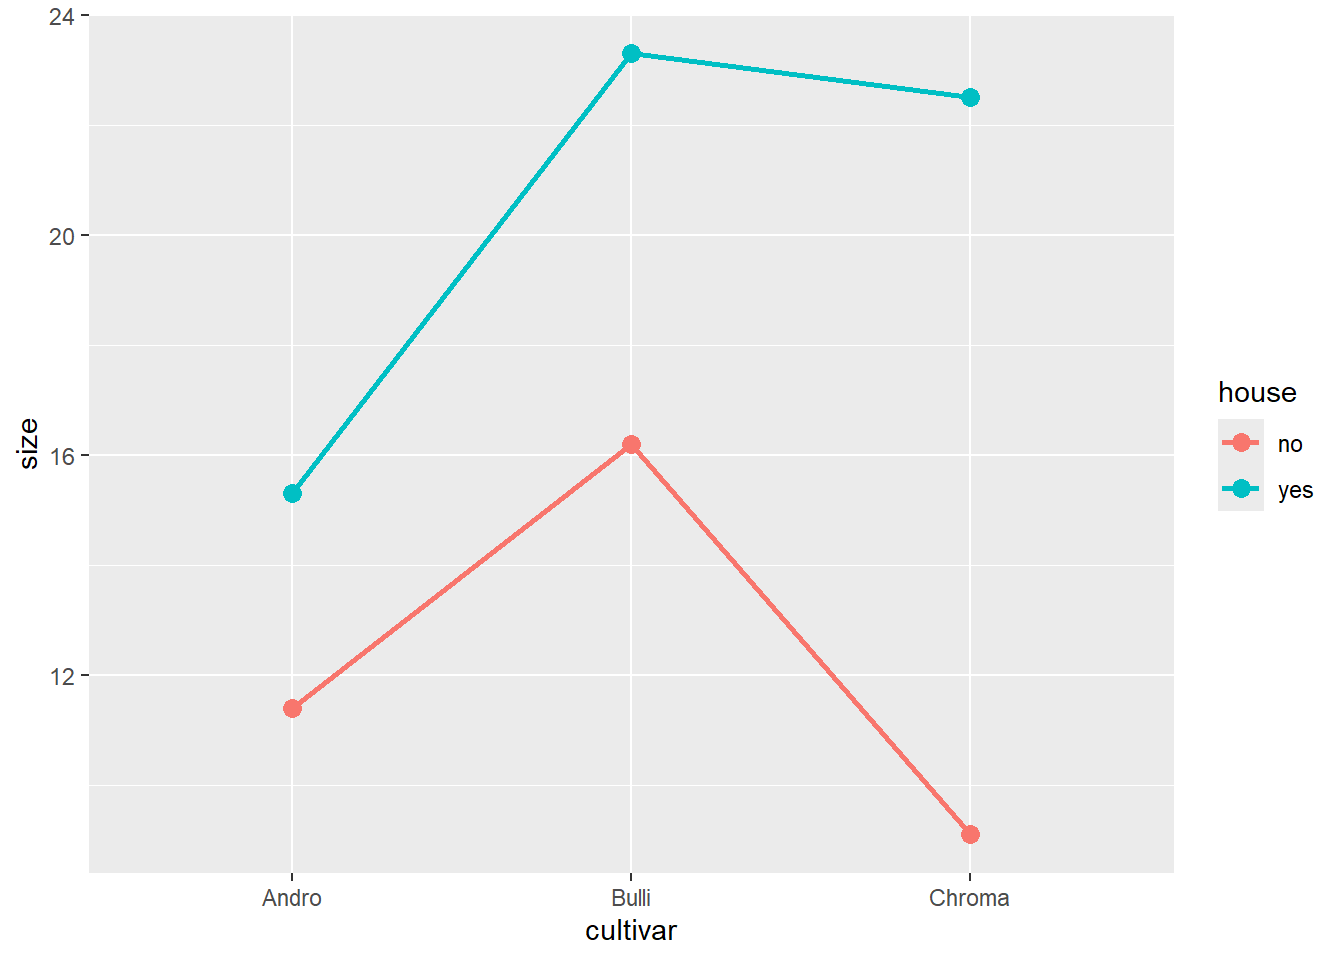
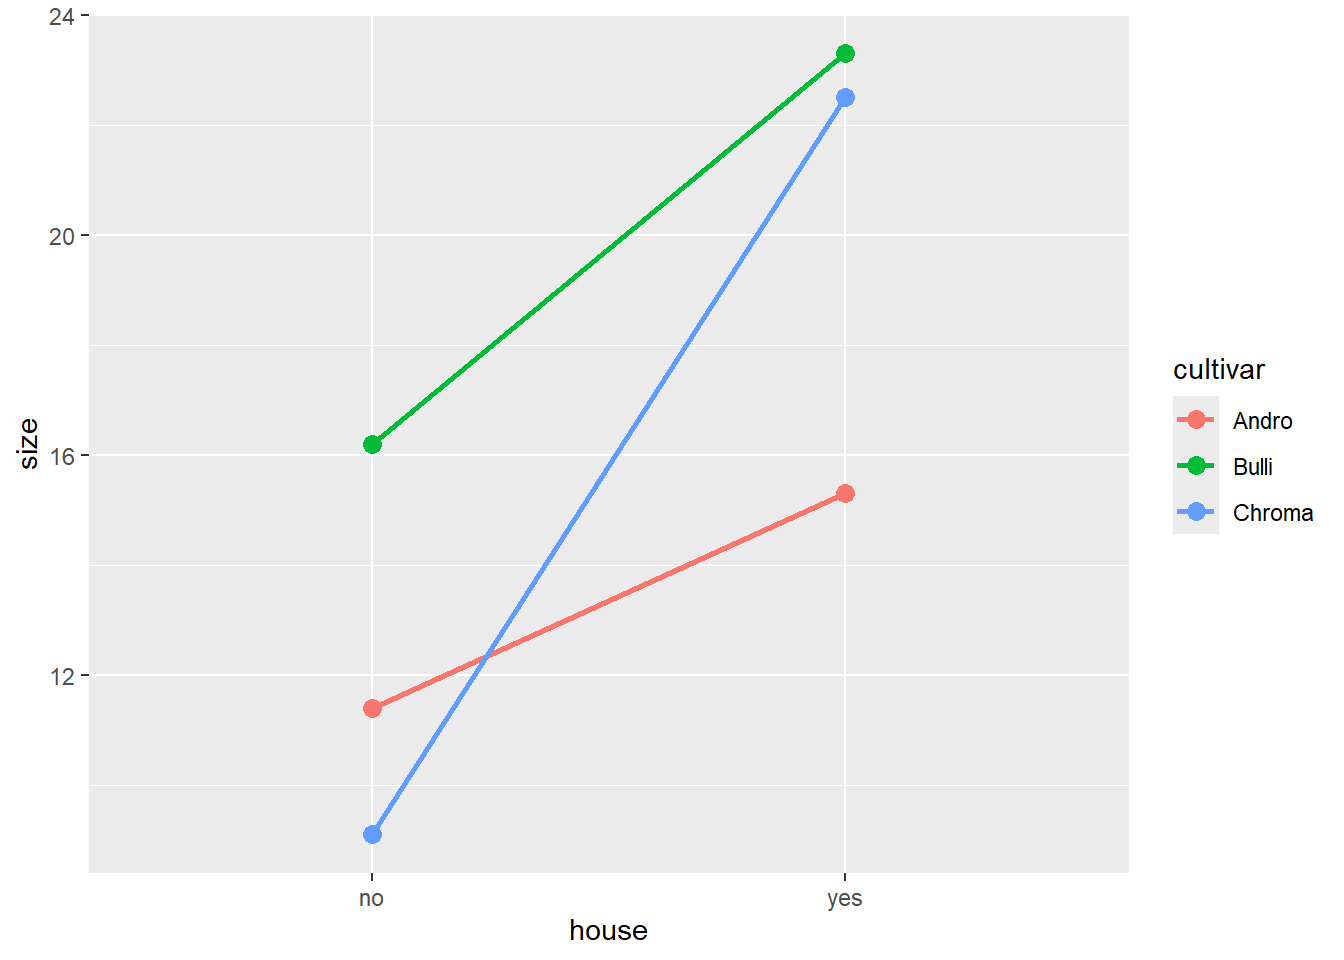
# Interaktionsplots
ggplot(blume3, aes(cultivar, size, color = house, group = house)) +
  stat_summary(fun = mean, geom = "point", size = 3) +
  stat_summary(fun = mean, geom = "line", linewidth = 1) 

ggplot(blume3, aes(house, size, color = cultivar, group = cultivar)) +
  stat_summary(fun = mean, geom = "point", size = 3) +
  stat_summary(fun = mean, geom = "line", linewidth = 1) 

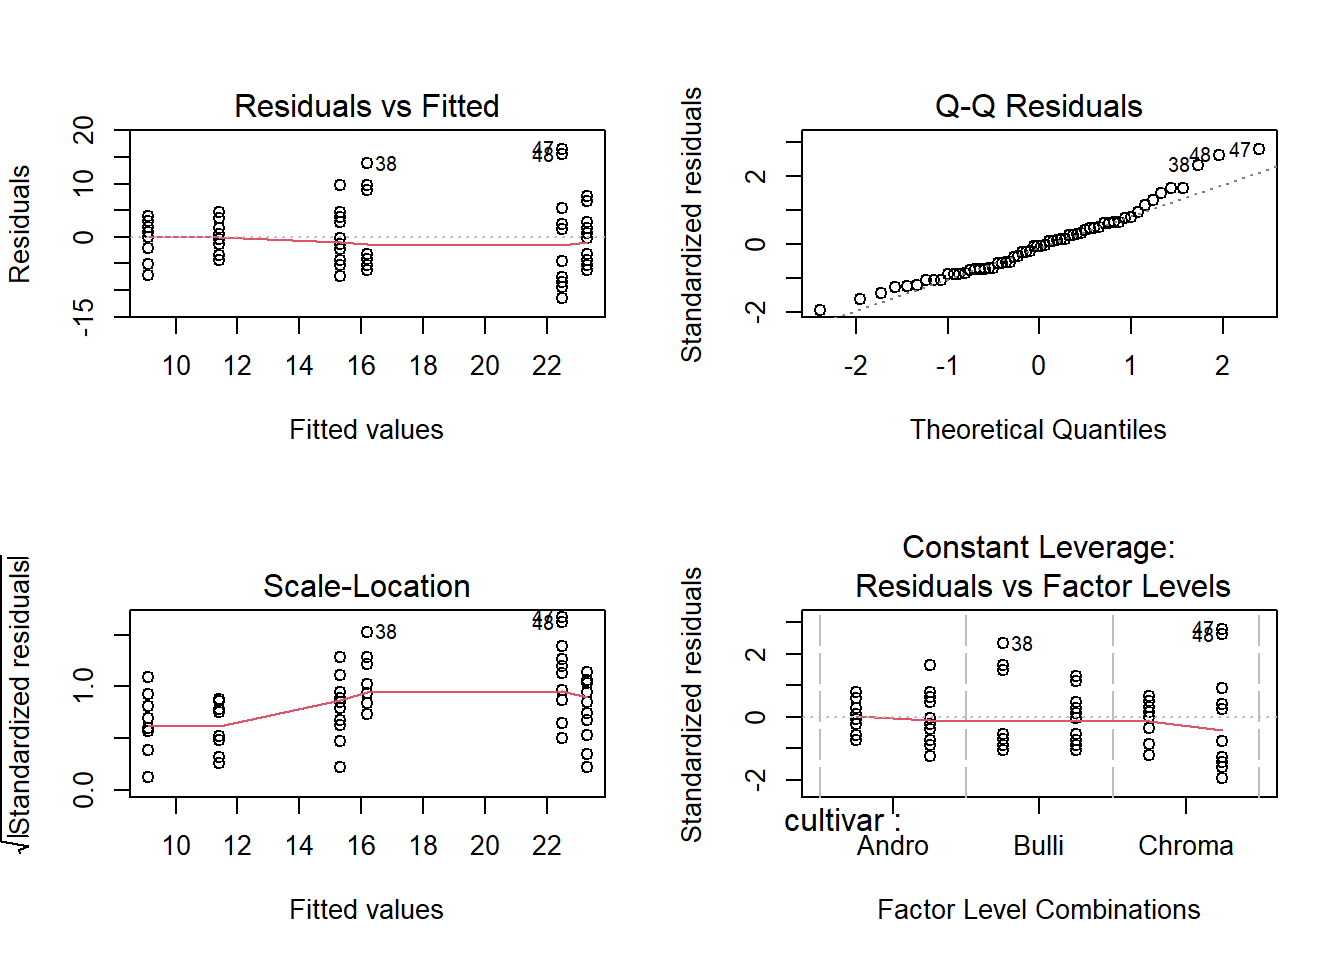
Modelldiagnostik

Beispiel Modelldiagnostik

# 4 Plots in einem Fenster
par(mfrow = c(2, 2))
plot(aov_4b)

Nicht-parametrische Alternativen zur ANOVA

Kruskal-Wallis-Test bei starken Abweichungen von der Normalverteilung, aber ähnlichen Varianzen

# Zum Vergleich normale ANOVA noch mal
summary(aov_2)
            Df Sum Sq Mean Sq F value   Pr(>F)    
cultivar     2  736.1   368.0    18.8 7.68e-06 ***
Residuals   27  528.6    19.6                     
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
# Kruskal-Wallis-Test
kruskal.test(size ~ cultivar, data = blume2)

    Kruskal-Wallis rank sum test

data:  size by cultivar
Kruskal-Wallis chi-squared = 16.686, df = 2, p-value = 0.0002381
library("FSA")
# Post-Hoc mit korrigierten p-Werte nach Bejamini-Hochberg
dunnTest(size ~ cultivar, method = "bh", data = blume2)
      Comparison         Z      P.unadj        P.adj
1  Andro - Bulli  1.526210 1.269575e-01 0.1269575490
2 Andro - Chroma -2.518247 1.179407e-02 0.0176911039
3 Bulli - Chroma -4.044457 5.244459e-05 0.0001573338

Welch Anova bei erheblicher Heteroskedastizität, aber relative normal/symmetrisch verteilten Residuen

# Welch Anova 
oneway.test(size ~ cultivar, var.equal = F, data = blume2)

    One-way analysis of means (not assuming equal variances)

data:  size and cultivar
F = 21.642, num df = 2.000, denom df = 16.564, p-value = 2.397e-05