library("readr")

wetter <- read_delim("datasets/prepro/weather.csv", delim = ",")
wetter$stn <- as.factor(wetter$stn)Prepro 4: KI als Tutor
Wir skripten, um aus Daten Erkenntnisse zu gewinnen, und R ist das Werkzeug dafür. Der Prozess, den Code zu entwicklen, besteht aus dem Lösen vieler kleiner Teilproblemen. Wenn man bei der Lösung eines Teilproblems Hilfe benötigt, gibt es dafür unterschiedliche Ressourcen, KI ist nur eine davon. In dieser Demo und den Übungen wollen wir einige dieser Ressourcen anschauen und vergleichen:
- R-Hilfe (
?funktionsname, Autocomplete-Tooltips): schnell, präzise, direkt im Editor - Paketdokumentation / Recherche / Cheatsheets: gut, wenn man nicht weiss, wonach man suchen soll
- KI: hilfreich bei konzeptuellen, komplexen Fragen
Demo
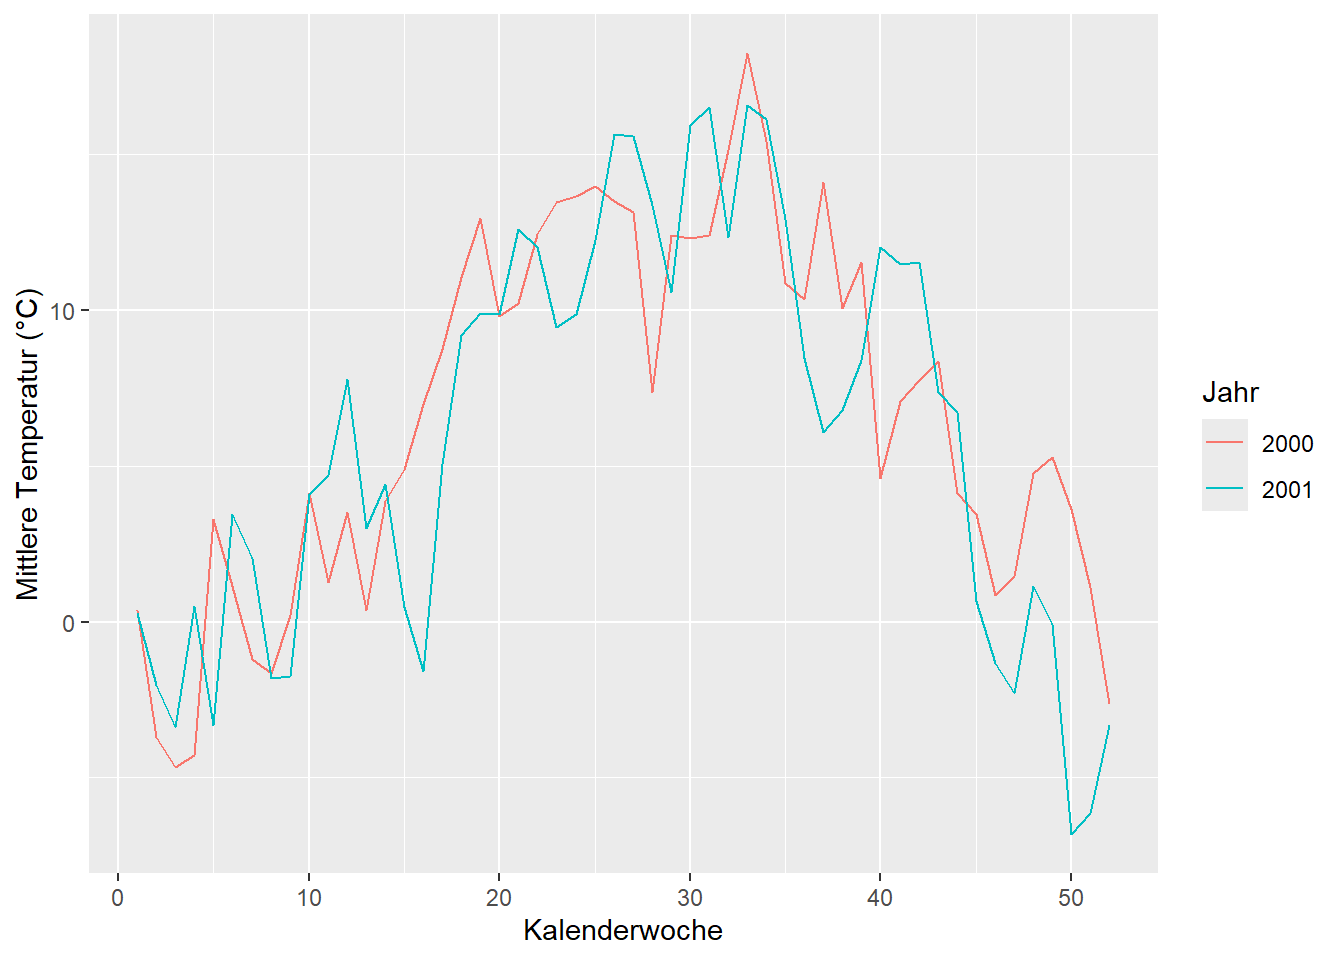
Analyse-Ziel: Die mittlere Temperatur pro Kalenderwoche für beide verfügbaren Jahre berechnen und als Linienplot vergleichen.
Schritt 1: R-Hilfe
Wir kennen read_delim aus Prepro 1. Aber was war nochmal das Argument für das Trennzeichen — hiess es sep oder delim?
→ ?read_delim in der R-Konsole ausführen und im Abschnitt Arguments nachschauen. Alternativ: read_delim( tippen und kurz warten — RStudio zeigt per Autocomplete-Tooltip die verfügbaren Argumente direkt im Editor an.
Schritt 2: KI — Nachschlagen und prüfen
Die Spalte time muss als POSIXct eingelesen werden. Dafür braucht as.POSIXct() eine Formatschablone. Die R-Hilfe ?strptime listet alle Codes auf — aber als Nachschlagewerk für ein konkretes Format ist sie mühsam. Auch eine Google-Suche führt hier selten direkt ans Ziel. Hier drängt sich die Nutzung von KI auf, indem ein Beispielwert aus der Spalte gezeigt und nach der passenden Schablone gefragt wird
→ Schau dir zuerst an, wie die Werte in time aussehen:
head(wetter$time)
## [1] 2000010100 2000010101 2000010102 2000010103 2000010104 2000010105
→ Dann einen gezielten Prompt formulieren:
«Ein Wert aus meiner Spalte
timesieht so aus:2000010100. Welche Formatschablone brauche ich füras.POSIXct()in R?»
Eine typische Antwort könnte so aussehen:
Das entspricht 01.01.2000, 00:00 Uhr.
%Y= 4-stellige Jahreszahl,%m= Monat,%d= Tag,%H= Stunde (00–23) → Formatschablone:"%Y%m%d%H"
Das klingt überzeugend — aber stimmt es? Hier lohnt es sich, die Antwort kritisch zu prüfen:
- Die Reihenfolge der Felder im Beispielwert (
2000 01 01 00) stimmt mit%Y%m%d%Hüberein - aber das muss mittels Überprüfung der Metadaten kontrolliert werden. - Die Zeitzone (UTC, aus der Datei
meta.txt) hat die KI nicht erwähnt — das Argumenttz = "UTC"muss man selbst ergänzen. - Die Formatcodes sind es wert, einmal kurz nachzuschlagen und die häufigsten zu notieren.
wetter$time <- as.POSIXct(as.character(wetter$time), format = "%Y%m%d%H", tz = "UTC")
WichtigWelche KI verwenden?
Nebst den bekannten KI-Anbieter gibt es sinnvolle, weniger bekannte Alternativen - insbesondere wenn man nicht möchte, dass Anfragen auf US-amerikanischen Servern landen. Ein bekanntes europäisches Beispiel ist Le Chat von Mistral aus Frankreich (kostenlos, kein Account zwingend nötig).
Schritt 3: Paketdokumentation
Wir brauchen das Jahr und die Kalenderwoche. year() aus lubridate kennen wir. Aber für die Kalenderwoche: war das week() oder isoweek()?
→ In der lubridate-Paketdokumentation nachschlagen (z.B. DuckDuckGO “lubridate week R”). Dort findet man week(), isoweek() und epiweek(). isoweek() entspricht der ISO-8601-Norm, auf der Paketdokumentation wird man zum entsprechenden Wikipedia Artikel verwiesen.
library("lubridate")
library("dplyr")

wetter <- wetter |>
  mutate(
    jahr = year(time),
    kw   = isoweek(time)
  )
Schritt 4: KI — Konzept verstehen
Wir wollen aggregieren: eine Zeile pro Jahr und Kalenderwoche. dplyr bietet dafür mutate() und summarise(). Wann nehme ich welches?
→ KI als Erklärer — mit einem gezielten Prompt:
Erkläre mir den Unterschied zwischen
mutate()undsummarise()in dplyr. In welcher Situation brauche ich welche Funktion?
Nach der Erklärung schreiben wir den Code selbst:
wetter_kw <- wetter |>
  group_by(jahr, kw) |>
  summarise(temp_mean = mean(tre200h0, na.rm = TRUE), .groups = "drop")
Schritt 5: KI — Orientierung
Wir wollen die Ergebnisse visualisieren — aber welches Package sollen wir überhaupt nehmen? In R gibt es mehrere Möglichkeiten. Hier eignet sich KI gut als erste Orientierung:
«Ich möchte in R zwei Zeitreihen als Linienplot darstellen, farblich nach Gruppe unterschieden. Welche Packages kommen dafür in Frage, und was würdest du empfehlen?»
Die KI nennt typischerweise ggplot2, Base-R-Grafik und evtl. plotly. Da wir ggplot2 bereits aus Prepro 3 kennen, wählen wir das — und stellen direkt eine Anschlussfrage:
«Wie erstelle ich mit
ggplot2einen Linienplot mit zwei Linien, die sich in der Farbe unterscheiden? Die x-Achse ist eine Zahl (Kalenderwoche), die y-Achse ein Messwert, und die Farbe soll eine Gruppierungsvariable kodieren.»
Den vorgeschlagenen Code lesen wir durch, verstehen ihn — und schreiben ihn dann selbst:
library("ggplot2")

ggplot(wetter_kw, aes(x = kw, y = temp_mean, colour = as.factor(jahr))) +
  geom_line() +
  labs(
    x      = "Kalenderwoche",
    y      = "Mittlere Temperatur (°C)",
    colour = "Jahr"
  )
Übung
Aufgabe 1: R-Hilfe vs. KI
Schlag die Funktion read_delim() auf zwei Wegen nach:
- Führe
?read_delimin der Konsole aus. - Stelle einer KI die Frage: «Was macht die Funktion
read_delim()in R, und welche Argumente sind besonders wichtig?»
Vergleiche die beiden Antworten:
- Was erfährst du aus
?read_delim, was die KI nicht erwähnt? - Was erklärt die KI besser als die Dokumentation?
- Für welche Situation würdest du künftig welche Ressource bevorzugen?
Aufgabe 2: Prompt-Qualität
Stelle einer KI zweimal dieselbe inhaltliche Frage — einmal so, wie jemand ohne R-Kenntnisse fragen würde, einmal mit dem Vokabular aus Prepro 1–3.
Ohne R-Kenntnisse: > «Wie berechne ich in einer Tabelle den Durchschnitt einer Spalte, aufgeteilt nach Gruppen?»
Mit R-Kenntnissen: > «Erkläre mir, wie group_by() und summarise() in dplyr zusammenarbeiten, um den Mittelwert einer Spalte pro Gruppe zu berechnen.»
Vergleiche die Antworten: Wie unterscheiden sie sich in Präzision und Nützlichkeit? Was sagt das darüber aus, wozu R-Grundkenntnisse gut sind — auch im Zeitalter von KI?
Aufgabe 3: Zwei Anbieter vergleichen
Stelle dieselbe Frage bei zwei verschiedenen KI-Tools (z.B. Le Chat und ChatGPT, oder zwei beliebige andere):
«Erkläre mir den Unterschied zwischen
left_joinundinner_joinin R anhand eines kurzen, konkreten Beispiels.»
Vergleiche die Antworten:
- Unterscheiden sie sich in Stil, Detailgrad oder Verständlichkeit?
- Sind beide korrekt? Gibt es Unterschiede in den Code-Beispielen?
Aufgabe 4: KI-Antwort verifizieren
Stelle einer KI folgende Frage:
«Ein Wert aus meiner Datumsspalte sieht so aus:
03/04/2020 14:00. Welche Formatschablone brauche ich füras.POSIXct()in R?»
Notiere die Antwort der KI, und überprüfe sie dann:
Hat die KI die richtige Schablone geliefert? Lief der Code fehlerfrei durch? Ergibt der Output Sinn?
TippMusterlösung
Die korrekte Schablone ist "%m/%d/%Y %H:%M" — 03/04/2020 steht im US-amerikanischen Format für den 4. März 2020 (Monat/Tag/Jahr). Der Output sollte "2020-03-04 14:00:00" (mit der Systemzeitzone) ergeben.
as.POSIXct("03/04/2020 14:00", format = "%m/%d/%Y %H:%M")
## [1] "2020-03-04 14:00:00 CET"
Die typische Stolperfalle: KIs interpretieren 03/04 häufig als europäisches Format (Tag/Monat) und liefern %d/%m/%Y — was den 3. April als 4. März ausgibt. Entscheidend ist, ob man das Format kennt oder nachfragt.
Aufgabe 5: Energieverbrauch
Ein KI-Query ist kein kostenloser Vorgang — weder finanziell noch energetisch. Generative Sprachmodelle verursachen pro Anfrage um Grössenordnungen mehr Energie und CO₂-Emissionen als aufgabenspezifische Modelle (Luccioni u. a. 2024). Lokale Abfragen wie ?read_delim oder einfache Webseitenaufrufe verbrauchen im Vergleich dazu einen verschwindend kleinen Bruchteil der Energie.
Schaue dir nochmals die Aufgaben 1–4 an und überlege:
- Bei welchen dieser Aufgaben war der Einsatz von KI aus deiner Sicht gerechtfertigt — also hat die KI etwas geleistet, das
?oder die Paketdokumentation nicht ebenso gut gekonnt hätte? - Bei welchen Aufgaben wäre
?oder eine Suche in der Dokumentation die energieeffizientere und gleichwertige Alternative gewesen?