# .##################################################################################
# Daten(vor)verarbeitung Fallstudie WPZ  ####
# Modul Research Methods, HS26. Autor/in ####
# .##################################################################################Datenverarbeitung Feldaufnahmen
Projektaufbau RStudio-Projekte
Vor den eigentlichen Auswertungen müssen einige vorbereitende Arbeiten unternommen werden. Die Zeit, die man hier investiert, wird in der späteren Projektphase um ein vielfaches eingespart. Im Skript soll die Ordnerstruktur des Projekts genannt werden, damit der Arbeitsvorgang auf verschiedenen Rechnern reproduzierbar ist.
Arbeitet mit Projekten, da diese sehr einfach untereinander ausgetauscht und somit auch reproduziert werden können; es gibt keine absoluten Arbeitspfade sondern nur relative. Der Datenimport (und auch der Export) kann mithilfe dieser relativen Pfaden stark vereinfacht werden. Projekte helfen alles am richtigen Ort zu behalten. (mehr zur Arbeit mit Projekten: Link)
Aufbau von R-Skripten
Im Kopf des Skripts zuerst immer den Titel des Projekts sowie die Autor:innen des Skripts nennen. Hier soll auch die Herkunft der Daten ersichtlich sein und falls externe Daten verwendet werden, sollte geklärt werden, wer die Datenherrschaft hat (Rehdaten: Forschungsgruppe WILMA).
Beschreibt zudem folgendes:
- Ordnerstruktur; ich verwende hier den Projektordner mit den Unterordnern:
- Skripts
- Data
- Results
- Plots
- Verwendete Daten
Ein Skript soll in R eigentlich immer nach dem selbem Schema aufgebaut sein. Dieses Schema beinhaltet (nach dem bereits erwähnten Kopf des Skripts) 4 Kapitel:
- Datenimport
- Datenvorverarbeitung
- Analyse
- Visualisierung
Bereitet euer Skript also nach dieser Struktur vor. Nutzt für den Text, welcher nicht Code ist, vor dem Text das Symbol #. Wenn ihr den Text als Titel definieren wollt, der die grobe Struktur des Skripts absteckt, baut in wie in folgendem Beispiel auf:
# .###################################################################################
# METADATA ####
# .###################################################################################
# Datenherkunft ####
# ...

# .###################################################################################
# 1. DATENIMPORT ####
# .###################################################################################
Libraries laden
library("readr")
library("dplyr")
library("ggplot2")
library("purrr")
Daten laden
- Herunterladen der Daten der Feldaufnahmen von Moodle (Feldaufnahmen_alle_Gruppen.zip)
- Einlesen, Sichtung der Datensätze und der Datentypen.
Verschiedene Dinge werden beim Einlesen möglicherweise nicht auf Anhieb funktionieren oder es zeigt sich dann spätestens beim Zusammenfügen zu einem Gesamtdatensatz, dass es Probleme gibt (zB. mit den Datentypen und/oder Spaltenbezeichnungen). Versucht wenn möglich diese Dinge jeweils direkt mit R zu lösen, dies ist vorallem bei grösseren Datensätzen extrem hilfreich, damit die Datensätze zu einem sauberen Gesamtdatensatz zusammengefügt werden können.
Musterlösung
df_team1 <- read_delim("datasets/fallstudie_n/Feldaufnahmen_alle_Gruppen/gruppe1_felderhebungen.csv", delim = ";")

df_team2 <- read_delim("datasets/fallstudie_n/Feldaufnahmen_alle_Gruppen/Felderhebung_Waldstruktur_Team_Gelb.csv", delim = ";")

df_team3 <- read_delim("datasets/fallstudie_n/Feldaufnahmen_alle_Gruppen/ground_truth_Gruppe_3_pink.csv", delim = ";")

df_team4 <- read_delim("datasets/fallstudie_n/Feldaufnahmen_alle_Gruppen/Felderhebungen_Waldstruktur_Team4.csv", delim = ";")

df_team5 <- read_delim("datasets/fallstudie_n/Feldaufnahmen_alle_Gruppen/felderhebungen_waldstruktur_team5.csv", delim = ",")

df_team6 <- read_delim("datasets/fallstudie_n/Feldaufnahmen_alle_Gruppen/Gruppe_6.csv", delim = ";")


# Die eingelesenen Datensätze anschauen und versuchen zu einem Gesamtdatensatz
# verbinden. Ist der Output zufriedenstellend?

df_gesamt <- bind_rows(df_team1, df_team2, df_team3, df_team4, df_team5, df_team6)
str(df_gesamt)
## spc_tbl_ [149 × 21] (S3: spec_tbl_df/tbl_df/tbl/data.frame)
##  $ kreis                         : num [1:149] 0 1 2 3 4 5 6 7 8 9 ...
##  $ X                             : num [1:149] 684900 684875 684875 684875 684850 ...
##  $ Y                             : num [1:149] 237175 237125 237175 237250 237225 ...
##  $ dg_rubus                      : num [1:149] 12 25 6 35 20 1 20 15 40 65 ...
##  $ dg_strauchschicht             : num [1:149] 4 13 5 40 55 40 60 60 23 25 ...
##  $ dg_baumschicht                : num [1:149] 66 70 57 45 40 66 55 45 80 67 ...
##  $ Kreis (r 12.5m)               : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ Deckungsgrad Rubus sp. [%]    : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ DG Strauchschicht [%] (0.5-3m): num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ DG Baumschicht [%] (ab 3m)    : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ fid                           : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ x                             : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ y                             : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ gruppe                        : chr [1:149] NA NA NA NA ...
##  $ farbe                         : chr [1:149] NA NA NA NA ...
##  $ dg_rubus_s                    : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ dg_strauch                    : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ dg_baumsch                    : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ deckungsgrad_rubus            : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $ deckungsgrad_strauchschicht   : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  $  deckungsgrad_baumschicht     : num [1:149] NA NA NA NA NA NA NA NA NA NA ...
##  - attr(*, "spec")=
##   .. cols(
##   ..   kreis = col_double(),
##   ..   X = col_double(),
##   ..   Y = col_double(),
##   ..   dg_rubus = col_double(),
##   ..   dg_strauchschicht = col_double(),
##   ..   dg_baumschicht = col_double()
##   .. )
##  - attr(*, "problems")=<externalptr>
Aufgabe 1
- Einfügen zusätzliche Spalte pro Datensatz mit der Gruppenzugehörigkeit (Team1-6)
- Spaltenumbenennung damit die Bezeichungen in allen Datensätzen gleich sind und der Gesamtdatensatz ohne Probleme zusammengefügt werden kann.
→ Zb. mit den befehlen mutate und rename & mit pipes (alt: %>%, neu: |>) in einem Schritt möglich
Musterlösung
# .#################################################################################
# 2. DATENVORVERARBEITUNG #####
# .#################################################################################

df_team1 <- df_team1 |>
  mutate(team = "team1") |>
  rename(
    KreisID = "kreis",
    DG_Rubus = "dg_rubus",
    DG_Strauchschicht = "dg_strauchschicht",
    DG_Baumschicht = "dg_baumschicht"
  )

df_team2 <- df_team2 |>
  mutate(team = "team2") |>
  rename(
    KreisID = "Kreis (r 12.5m)",
    DG_Rubus = "Deckungsgrad Rubus sp. [%]",
    DG_Strauchschicht = "DG Strauchschicht [%] (0.5-3m)",
    DG_Baumschicht = "DG Baumschicht [%] (ab 3m)"
  )

df_team3 <- df_team3 |>
  dplyr::select(-c(farbe, gruppe)) |>
  mutate(team = "team3") |>
  rename(
    KreisID = "fid",
    X = "x",
    Y = "y",
    DG_Rubus = "dg_rubus_s",
    DG_Strauchschicht = "dg_strauch",
    DG_Baumschicht = "dg_baumsch"
  )

df_team4 <- df_team4 |>
  mutate(team = "team4") |>
  rename(
    KreisID = "Kreis (r 12.5m)",
    DG_Rubus = "Deckungsgrad Rubus sp. [%]",
    DG_Strauchschicht = "DG Strauchschicht [%] (0.5-3m)",
    DG_Baumschicht = "DG Baumschicht [%] (ab 3m)"
  )

df_team5 <- df_team5 |>
  mutate(team = "team5") |>
  rename(
    KreisID = "kreis",
    X = "x",
    Y = "y",
    DG_Rubus = "deckungsgrad_rubus",
    DG_Strauchschicht = "deckungsgrad_strauchschicht",
    DG_Baumschicht = " deckungsgrad_baumschicht"
  )

df_team6 <- df_team6 |>
  mutate(team = "team6") |>
  rename(
    KreisID = "Kreis (r 12.5m)",
    DG_Rubus = "Deckungsgrad Rubus sp. [%]",
    DG_Strauchschicht = "DG Strauchschicht [%] (0.5-3m)",
    DG_Baumschicht = "DG Baumschicht [%] (ab 3m)"
  )
Beim Erfassen und Dokumentieren von Daten aus verschiedenen Quellen sollte darauf geachtet werden, dass dies möglichst einheitlich passiert (Dateiformate, Spalten, Bezeichnungen, Datentypen, usw.), damit kann man sich einiges an Arbeit ersparen. Hilfreich ist in diesem Zusammenhang immer ein klares und sauberes Feldprotokoll resp. eine Vorlage für die Erfassung der Daten zu erstellen.
Aufgabe 2
Zusammenführen der Teildatensätze aller Gruppen zu einem Gesamtdatensatz mit einheitlichen Spaltennamen
Musterlösung
df_gesamt <- bind_rows(df_team1, df_team2, df_team3, df_team4, df_team5, df_team6)Aufgabe 3
Verbinden (join) des Datensatzes der Felderhebungen mit dem Datensatz der LIDAR Variablen in den Reh-Kreisen (Reh_Kreise_LIDAR_Waldstruktur_261013.csv).
→ Welche Art von join?
→ Welche Spalten zum Verbinden (join_by()) der beiden Datensätze?
Ziel: ein Datensatz mit allen Kreisen der Felderhebung, angereichert mit den Umweltvariablen Understory und Overstory aus den LIDAR-Daten (DG_us_2022, DG_os_2022) aus dem LIDAR-Waldstruktur-Datensatz.
Musterlösung
# hier können die Probekreise mit den Angaben zur Anzahl Rehlokalisationen und der
# LIDAR-basierten Ableitung der Waldstruktur eingelesen werden

df_lidar <- read_delim("datasets/fallstudie_n/Reh_Kreise_LIDAR_Waldstruktur_261013.csv", delim = ";")
str(df_lidar)
## spc_tbl_ [305 × 7] (S3: spec_tbl_df/tbl_df/tbl/data.frame)
##  $ Anz_reh_lokalisationen: num [1:305] 0 0 0 0 0 0 0 0 0 0 ...
##  $ x                     : num [1:305] 684900 684900 684900 684900 684875 ...
##  $ y                     : num [1:305] 237100 237125 237150 237175 237075 ...
##  $ DG_us_2014            : num [1:305] 0.0903 0.2717 0.468 0.7407 0.1811 ...
##  $ DG_os_2014            : num [1:305] 0.908 0.959 0.871 0.986 0.86 ...
##  $ DG_us_2022            : num [1:305] 0.269 0.823 0.936 0.359 0.245 ...
##  $ DG_os_2022            : num [1:305] 0.945 0.99 0.953 0.997 0.898 ...
##  - attr(*, "spec")=
##   .. cols(
##   ..   Anz_reh_lokalisationen = col_double(),
##   ..   x = col_double(),
##   ..   y = col_double(),
##   ..   DG_us_2014 = col_double(),
##   ..   DG_os_2014 = col_double(),
##   ..   DG_us_2022 = col_double(),
##   ..   DG_os_2022 = col_double()
##   .. )
##  - attr(*, "problems")=<externalptr>

df_with_LIDAR <- left_join(df_gesamt, df_lidar, join_by(X == x, Y == y))
Aufgabe 4
Scatterplot der Waldstrukturvariablen aus den Felderhebungen gegen die entsprechenden Waldstrukturvariablen aus den LiDAR-Daten (DG_xy_2022) erstellen (zusätzlich Einfärben der Gruppen und Regressionslinie darüberlegen).
→ Wie gut korrelieren die Daten der Feldaufnahmen mit der LiDAR basierten Waldstruktur?
Im LiDAR Datensatz gibt es dieselben Variablen der Waldstruktur aus der LiDAR-Befliegung 2014. Ihr könnt untersuchen wie sich diese verändert haben und wie gut oder eben auch nicht sie mit euren Feldaufnahmen übereinstimmen.
Musterlösung
# .#####################################################################################
# 4. VISUALISERUNG #####
# .#####################################################################################

ggplot(df_with_LIDAR, aes(DG_us_2022, DG_Strauchschicht, color = team)) +
  geom_point() +
  stat_smooth(method = "lm") +
  xlim(0, 1) +
  ylim(0, 100) +
  geom_abline(slope = 100, intercept = 0, linetype = "dashed", color = "red")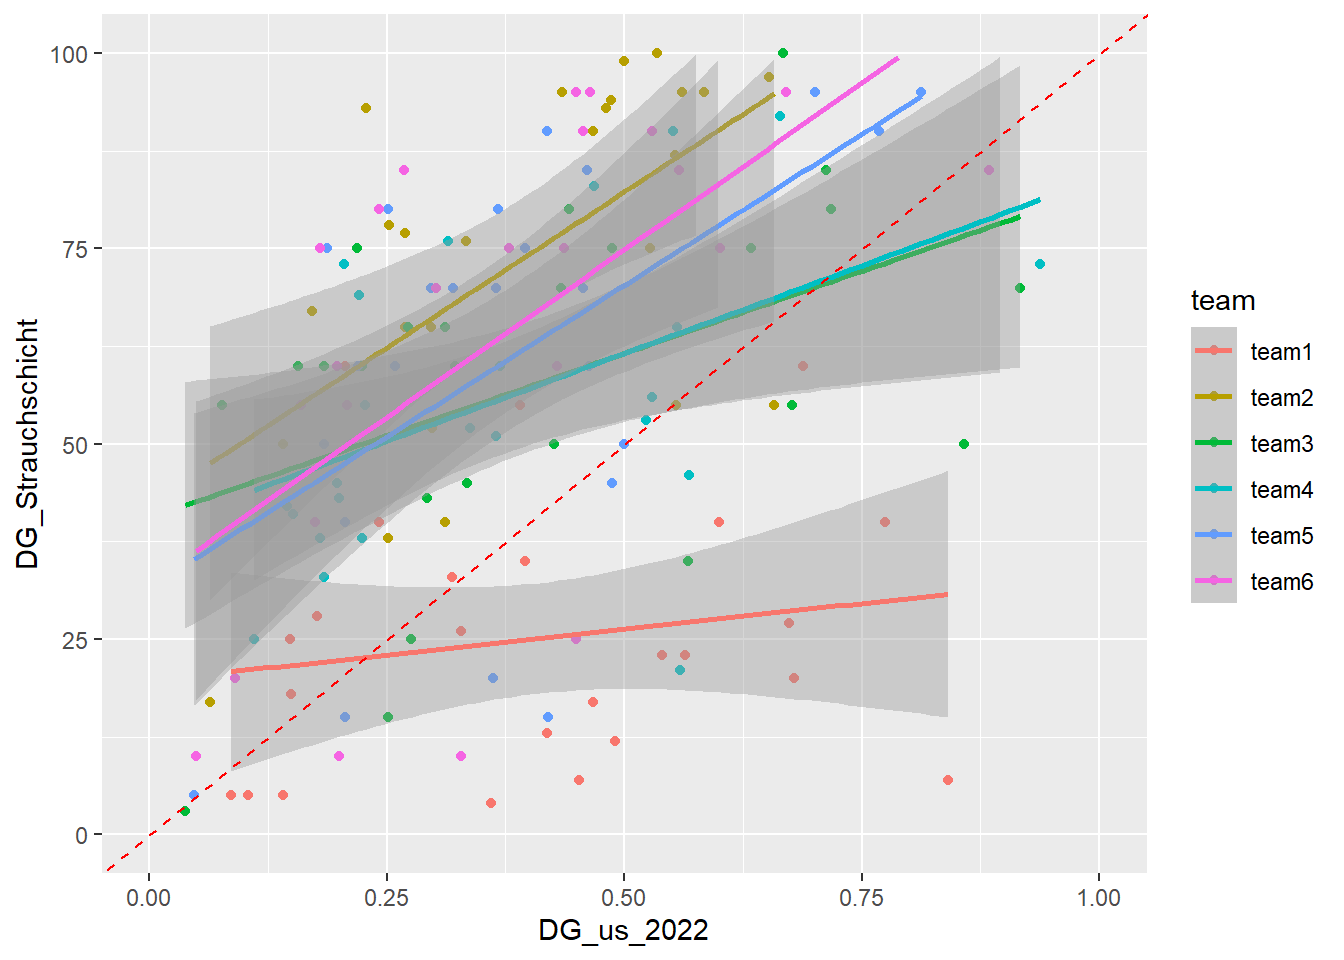
Musterlösung
write_delim(df_with_LIDAR, "datasets/fallstudie_n/df_with_lidar_2026.csv", delim = ";")

# Der lineare Zusammenhang der Variablen der Vegetationsschichten kann auch statistisch getestet werden (Korrelation; Funktion cor.test). *Die Theorie dazu in den Vormittagslektionen zu Korrelation folgt allerdings erst ab 26.10.*

cor.test(~ DG_Strauchschicht + DG_us_2022, data = df_with_LIDAR, method = "pearson")
##
##  Pearson's product-moment correlation
##
## data:  DG_Strauchschicht and DG_us_2022
## t = 4.7851, df = 147, p-value = 4.12e-06
## alternative hypothesis: true correlation is not equal to 0
## 95 percent confidence interval:
##  0.2192536 0.4984844
## sample estimates:
##       cor
## 0.3671107