## # A tibble: 3 × 2
##   name    temp_mean
##   <chr>       <dbl>
## 1 sensor1      14.7
## 2 sensor2      12.0
## 3 sensor3 14.4Prepro 3: Übung
Aufgabe 1
Gegeben sei ein Datensatz sensors_combined.csv mit den Temperaturwerten von drei verschiedenen Sensoren. Importiere ihn als csv in R (als sensors_combined).
Formatiere die Datetime Spalte in POSIXct um. Verwende dazu die Funktion as.POSIXct (lies mit ?strftime() nochmal nach, wie du das spezifische Format (die “Schablone”) festlegen kannst).
Aufgabe 2
Überführe die Tabelle in ein langes Format (verwende dazu die Funktion pivot_longer aus tidyr) und speichere den output als sensors_long.
Tipp:
- im Argument
colskannst du entweder die Spalten auflisten, die “pivotiert” werden sollen. - Alternativ kannst du (mit vorangestelltem Minuszeichen,
-) die Spalte bezeichnen, die nicht pivotiert werden soll. - In beiden Fällen musst du die Spalten weder mit Anführungs- und Schlusszeichen noch mit dem
$-Zeichen versehen.
Aufgabe 3
Gruppiere sensors_long nach der neuen Spalte, wo die Sensor-Information enthalten ist (default: name) mit group_by und berechne den Mittelwert der Temperatur pro Sensor (summarise). Hinweis: Beide Funktionen sind Teil des Packages dplyr.
Der Output sieht folgendermassen aus:
Aufgabe 4
Erstelle für sensors_long eine neue convenience Variabel month, welche den Monat beinhaltet (Tipp: verwende dazu die Funktion month aus lubridate). Gruppiere nun nach month und Sensor und berechne den Mittelwert der Temperatur.
Aufgabe 5
Importiere die Datei sensor_fail.csv in R.
sensor_fail.csv hat eine Variabel SensorStatus: 1 bedeutet der Sensor misst, 0 bedeutet der Sensor misst nicht. Fälschlicherweise wurde auch dann der Messwert Temp = 0 erfasst, wenn Sensorstatus = 0. Richtig wäre hier NA (not available). Korrigiere den Datensatz entsprechend.
| Sensor | Temp | Hum_% | Datetime | SensorStatus | Temp_correct |
|---|---|---|---|---|---|
| Sen102 | 0.6 | 98 | 16102017_1800 | 1 | 0.6 |
| Sen102 | 0.3 | 96 | 17102017_1800 | 1 | 0.3 |
| Sen102 | 0.0 | 87 | 18102017_1800 | 1 | 0.0 |
| Sen102 | 0.0 | 86 | 19102017_1800 | 0 | NA |
| Sen102 | 0.0 | 98 | 23102017_1800 | 0 | NA |
| Sen102 | 0.0 | 98 | 24102017_1800 | 0 | NA |
| Sen102 | 0.0 | 96 | 25102017_1800 | 1 | 0.0 |
| Sen103 | -0.3 | 87 | 26102017_1800 | 1 | -0.3 |
| Sen103 | -0.7 | 98 | 27102017_1800 | 1 | -0.7 |
| Sen103 | -1.2 | 98 | 28102017_1800 | 1 | -1.2 |
Aufgabe 6
Warum spielt es eine Rolle, ob 0 oder NA erfasst wird? Berechne den Mittelwert der Temperatur / Feuchtigkeit nach der Korrektur.
Aufgabe 7
Lade jetzt nochmal den Datensatz weather.csv (Quelle MeteoSchweiz) herunter und importiere ihn als CSV mit den korrekten Spaltentypen (stn als factor, time als POSIXct, tre200h0 als double).
Aufgabe 8
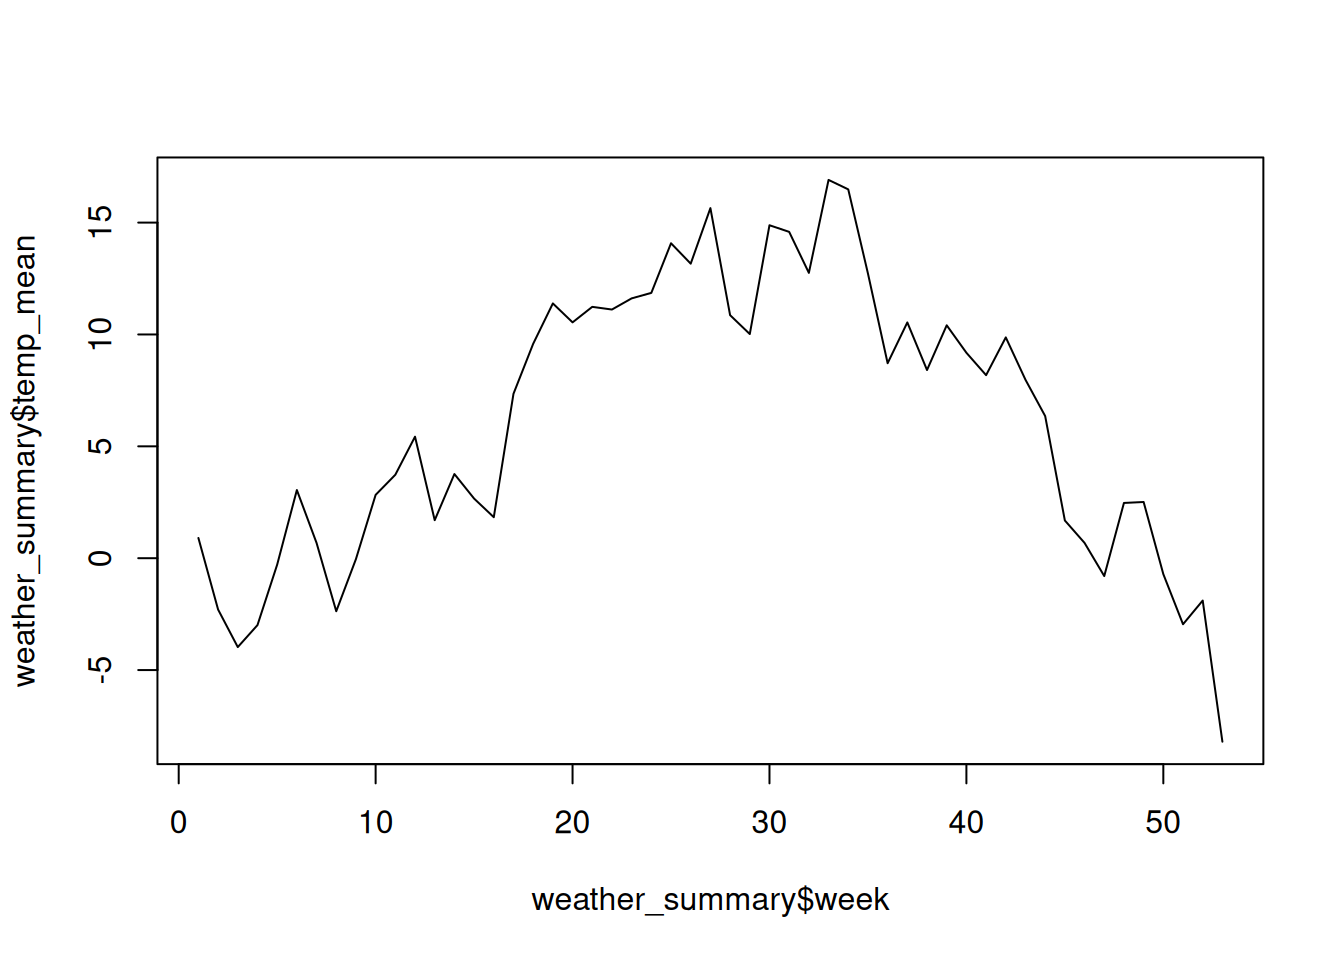
Erstelle nun eine convenience Variable für die Kalenderwoche pro Messung (lubridate::week). Berechne im Anschluss den Mittelwert der Temperatur pro Kalenderwoche.
Visualisiere im Anschluss das Resultat:
Aufgabe 9
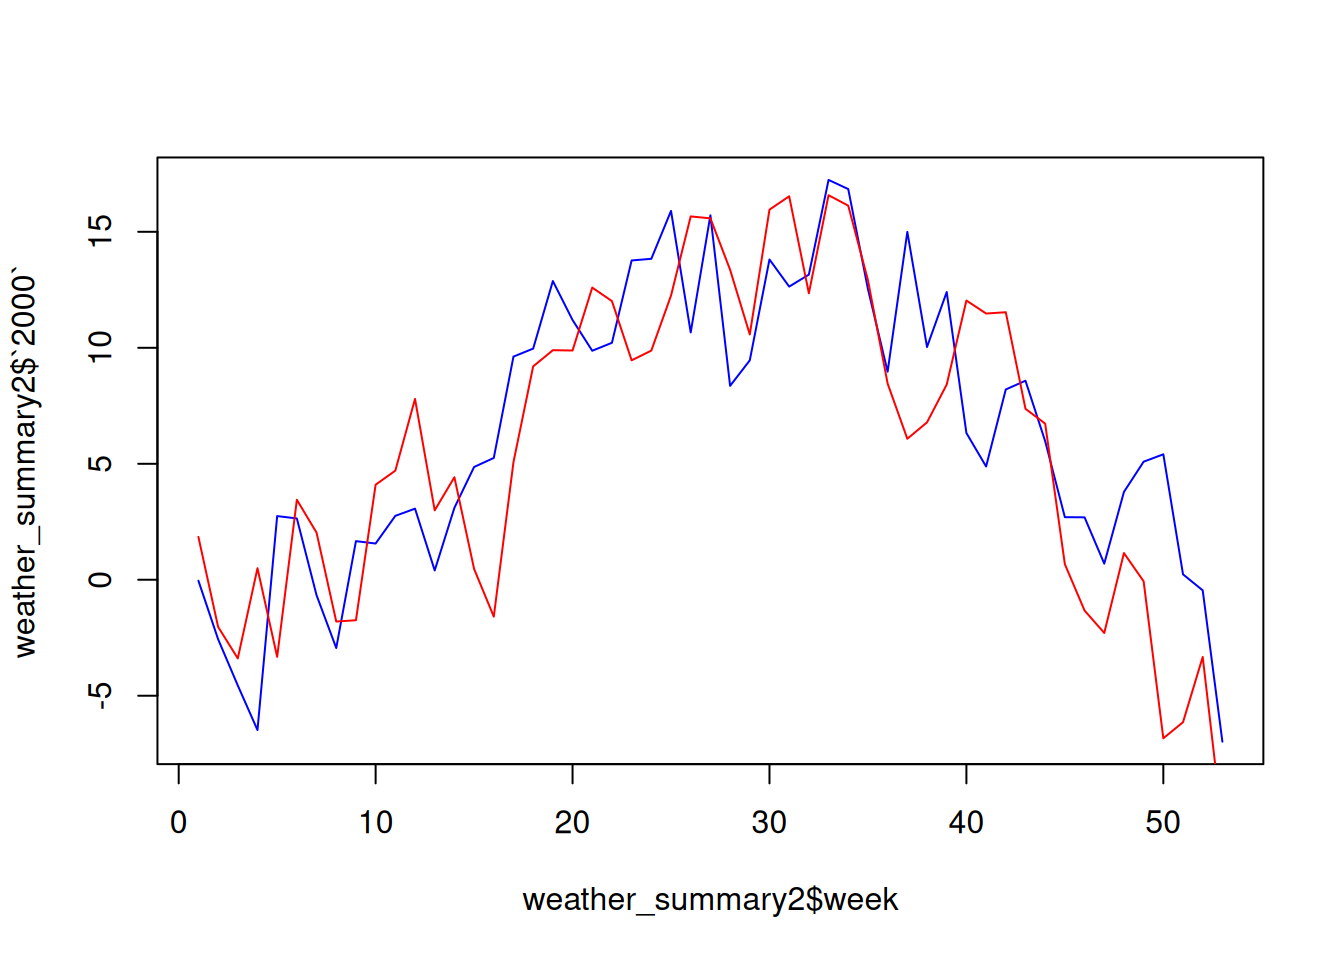
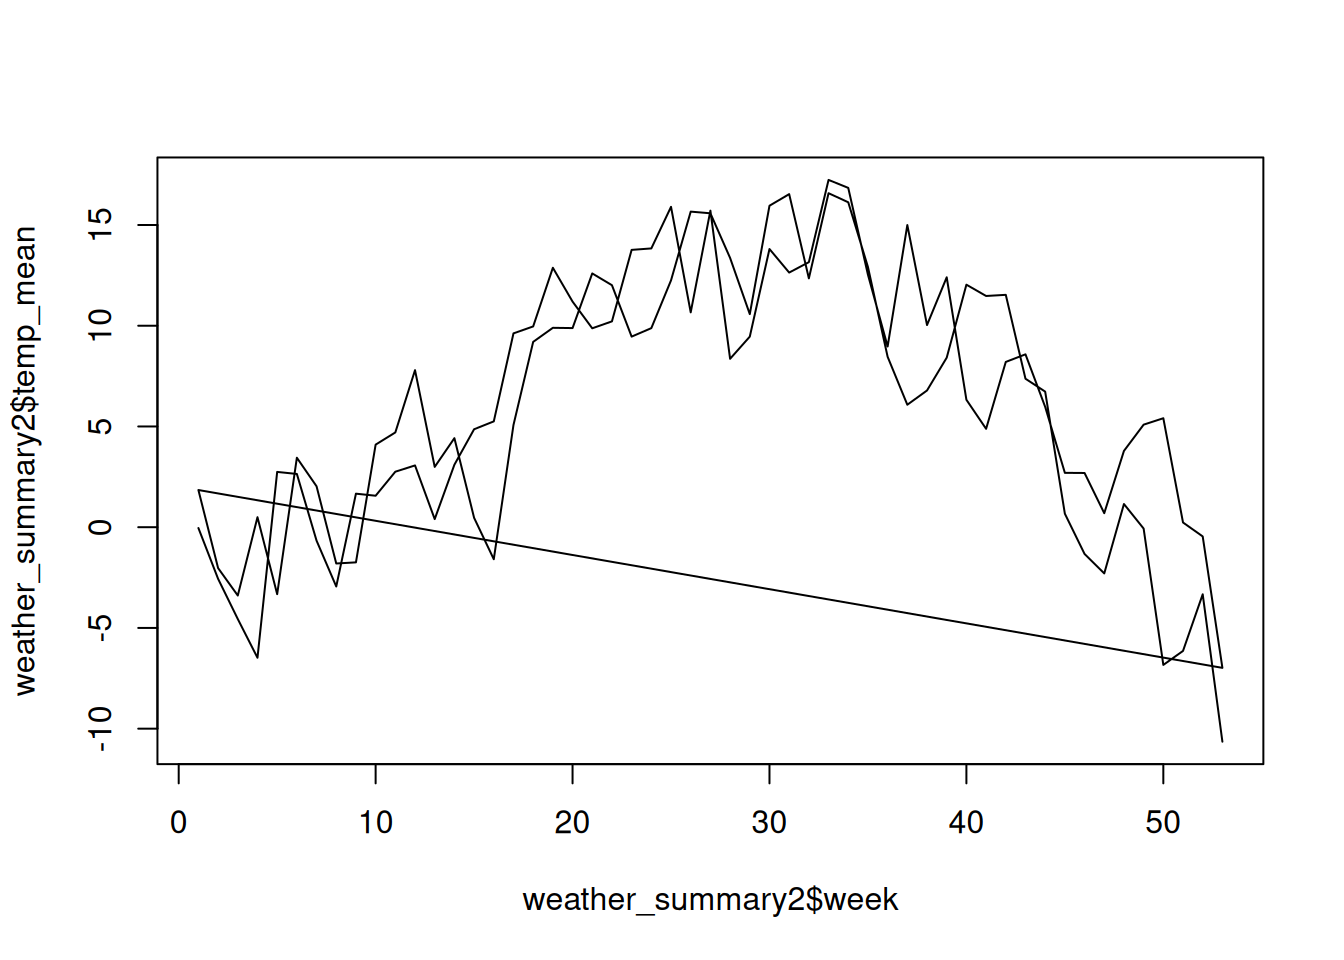
In der vorherigen Aufgabe haben wir den Mittelwert der Temperatur pro Kalenderwoche über alle Jahre (2000 und 2001) berechnet. Wenn wir die Jahre aber miteinander vergleichen wollen, müssen wir zuerst nach Jahr, dann nach Woche gruppieren und die Daten aggregieren. Versuche dies mit den Wetterdaten und visualisiere den Output anschliessend.
Aufgabe 10
Überführe den Output aus der letzten Übung in eine wide table. Nun lassen sich die beiden Jahre viel besser miteinander vergleichen.